آزمایش تصادفی 800 شرکت کننده: هشدار شفافیت به علاوه دقیق پذیرش پاسخ های اشتباه از 45٪ تا 21٪
یک آزمایش آنلاین تصادفی که در گزارش های علمی در تاریخ 14 نوامبر منتشر شد، بررسی کرد که آیا اطلاعات منبع قابل مشاهده و یک هشدار دقیق، وابستگی انتخابی بیشتری به پاسخ های عمومی هوش مصنوعی دارند. این مطالعه توسط Xing، ژانگ، ژانگ و همکارانش در 14 آگوست دریافت شد و در 11 نوامبر پذیرفته شد.
نمونه تحلیلی نهایی 800 شرکت کننده بزرگسال بود که به یکی از چهار بیماری اختصاص داده شده است. هر شرکت کننده 24 پاسخ سبک AI را ارزیابی کرد، مشاهدات 19200 سطح آزمایشی، در یک وضوح منبع عبور طراحی (absent vs. Present)، هشدار دقیق (در مقابل حال حاضر) و پاسخ صحیح (در مقابل درست، درست در شرکت کنندگان).
شرکت کنندگان پاسخ های صحیح را اغلب بیش از پاسخ های نادرست پذیرفتند و شکاف پذیرش صحیح در شرایط منبع به اضافه شدن بزرگ بود. در مدل محدود به کارآزمایی های پاسخ نادرست، پذیرش پاسخ های نادرست در شرایط کنترل در 45٪ (1080/600)، و در شرایط منبع تنها در 36٪ (864 / 1996)، وضعیت هشدار دهنده تنها در 28٪ (672/600)، و وضعیت منبع به اضافه جنگ در 21٪ (504 /600) بود. رفتار هماهنگ سازی در شرایط ترکیبی، در 52٪ (2496/4800) عالی بود.
نویسندگان می گویند که نشانه های کوتاه بر روی صفحه، پذیرش نادرست پاسخ را کاهش داده و تأیید را در وظایف کم خطر ارزیابی اطلاعات تشویق می کند، در حالی که اشاره می کند که تفاوت بین سوگیری پاسخ و حساسیت یک وضعیت مهم مرزی است.
منبع: GSM · ایالات متحده (نسخه انگلیسی · نسخه اصلی چینی)
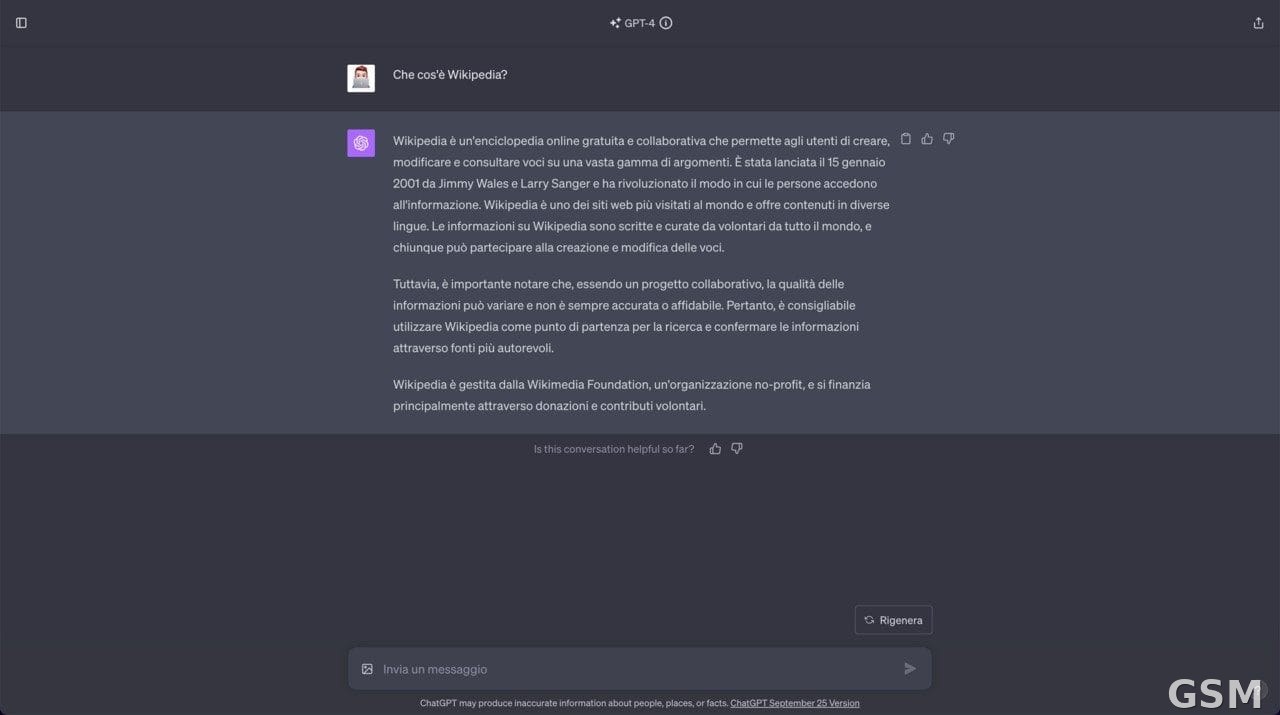
عکس: 图:ChatGPT 的对话界面截图,实验中的生成式答案即以此类界面呈现。作者:Lugab89,CC BY 3.0,维基共享资源。 / Photo: A ChatGPT conversation interface screenshot; the generative answers in the experiment were presented in interfaces of this kind. Credit: Lugab89, CC BY 3.0, via Wikimedia Commons.